말로 주문하면 효소가 나올까: Pinal이 보여준 단백질 설계의 현재
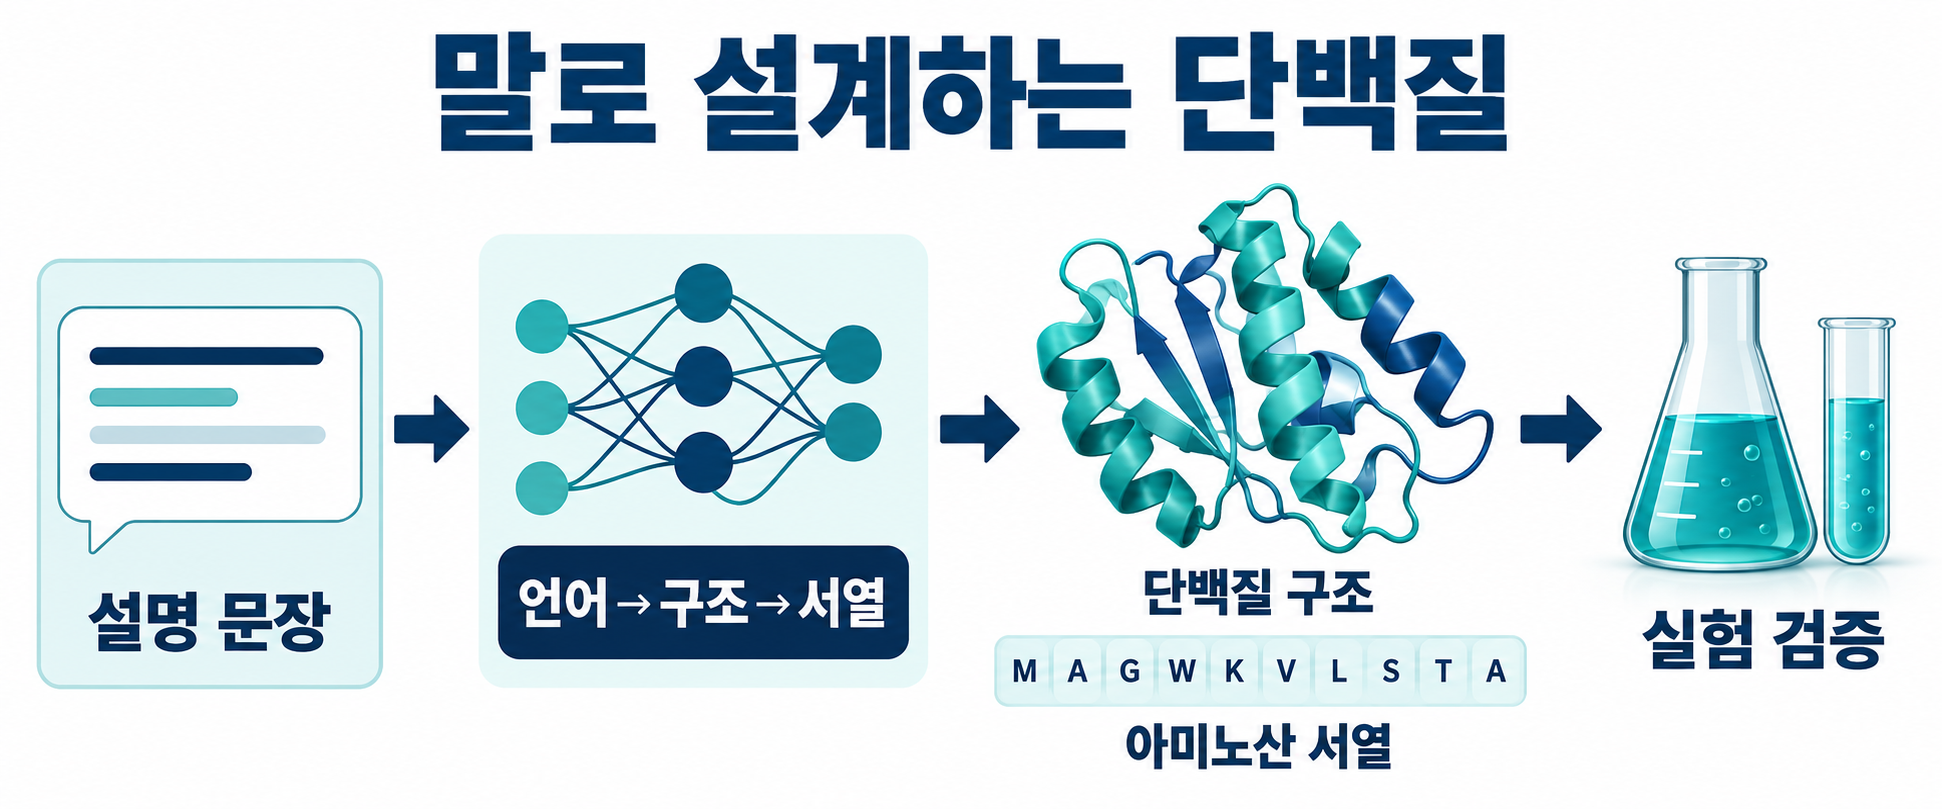
“형광을 내는 단백질을 만들어 줘”, “PET 플라스틱을 분해하는 효소가 필요해”처럼 원하는 기능을 문장으로 적으면 AI가 단백질 서열을 내놓는다고 하면 믿어지시나요? 이번 주 Nature에 실린 Pinal 연구가 이 장면을 실제 실험 결과와 함께 보여 주었습니다. 효소와 기능성 펩타이드를 다루는 식품·바이오 연구자에게 이 결과가 어디까지 쓸모 있고 어디서부터는 아직 기대인지 정리해 봅니다.
무엇이 나왔나: 문장을 입력받는 160억 파라미터 단백질 설계 모델
2026년 10월 21일 Dai 등은 「Programmable design of functional proteins from natural language」를 Nature에 발표했습니다. 이 논문은 2024년 8월부터 bioRxiv 프리프린트로 공개돼 여러 차례 수정을 거쳤고, 2025년 9월 투고 후 약 1년의 심사를 받았습니다.
Pinal은 160억(16B) 파라미터 규모의 기초 모델로, 합성적으로 주석을 단 단백질–텍스트 쌍 17억 개로 학습했습니다. 연구진은 네 가지 설계 과제, 즉 형광 단백질, PET(폴리에틸렌 테레프탈레이트) 분해효소, 알코올 탈수소효소(ADH), 대사 경로의 H-단백질에 이 모델을 적용했고, 네 경우 모두 의도한 기능을 실험으로 관찰했다고 보고합니다. 두 효소에서는 실제 촉매 활성이 확인됐습니다. 가장 눈에 띄는 수치는 H-단백질입니다. 반복적인 실험 최적화 없이 설계한 H-단백질이 다중 효소 CO2 고정 경로에서 대장균의 천연 H-단백질보다 생성물 역가를 1.7배 높였습니다.
어떻게 작동하나: 말 → 구조 → 서열
기존 단백질 설계는 대개 두 가지 출발점 중 하나가 필요했습니다. 이미 있는 천연 단백질을 조금씩 고쳐 나가거나, 연구자가 “이 위치에 이런 결합 주머니가 있어야 한다”처럼 기능 목표를 기하학적·서열 제약으로 직접 번역해 넣는 방식입니다. 둘 다 구조생물학 전문성과 시간이 많이 듭니다.
Pinal은 이 번역 단계를 모델에 맡깁니다. 기능 설명 문장을 받아 먼저 그 기능에 어울리는 구조를 떠올리고, 그 구조와 문장을 함께 조건으로 삼아 아미노산 서열을 생성하는 구조입니다. 비유하자면 건축가에게 “남향 거실이 넓은 3인 가족 집”이라고 말하면 평면도를 그린 뒤 자재 목록까지 뽑아 주는 셈입니다. 학습 데이터가 데이터베이스 주석을 바탕으로 만든 수많은 “단백질–설명” 쌍이기 때문에, 사람이 쓰는 기능 용어와 서열·구조 사이의 통계적 연결을 익힌 것입니다.
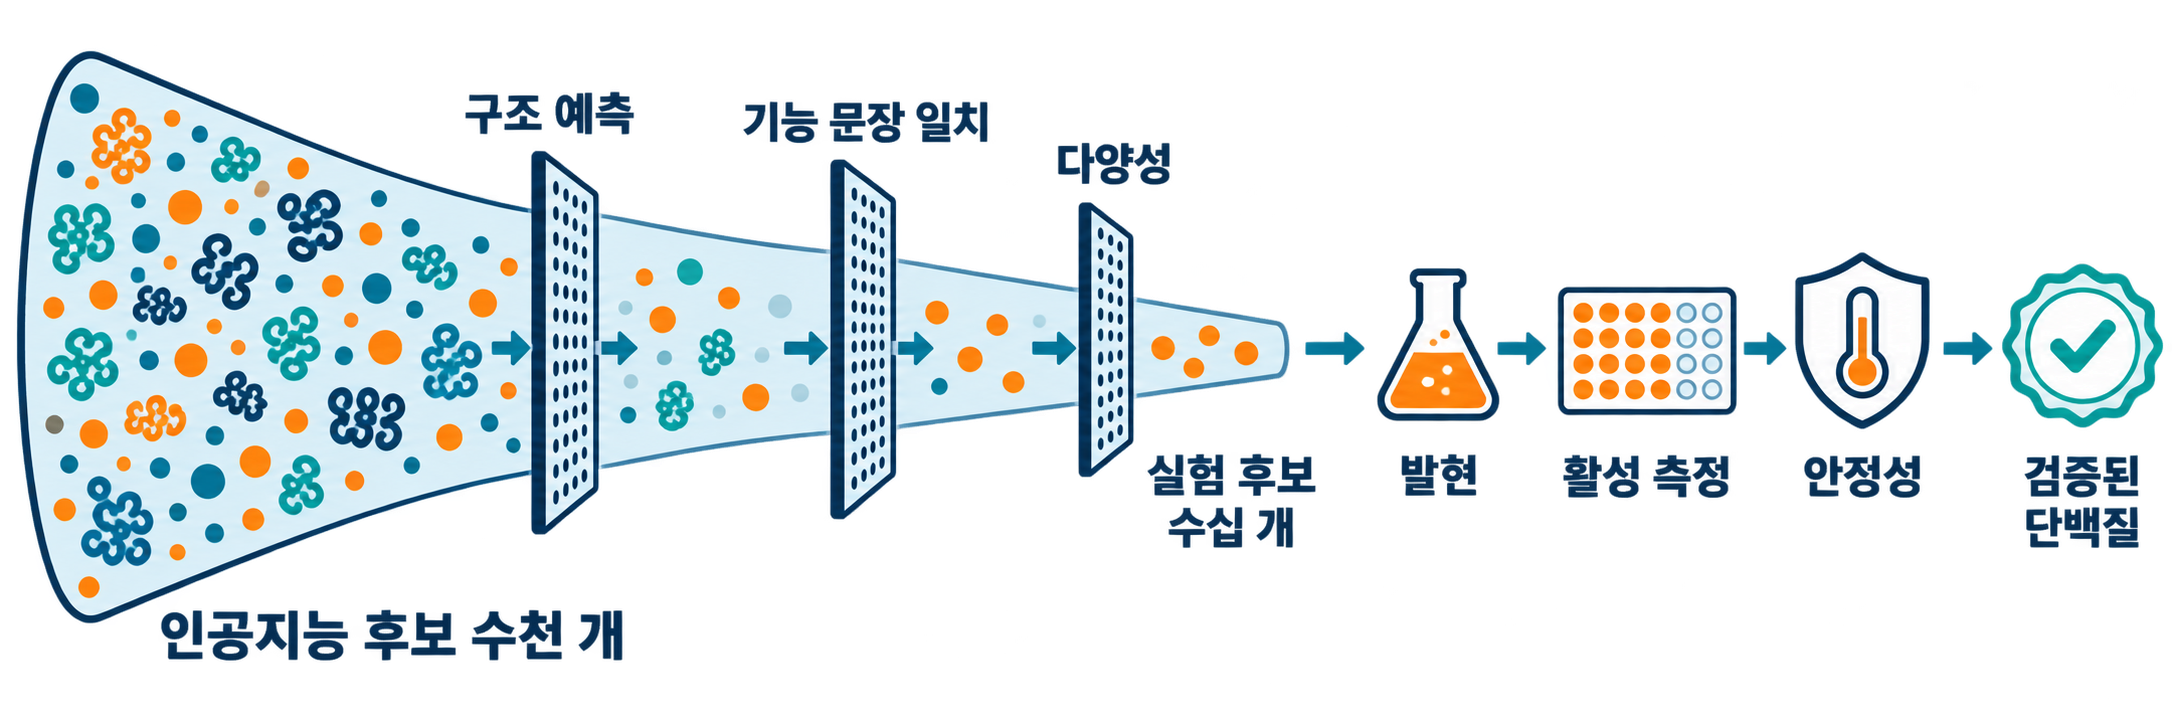
논문은 생성된 후보들이 구조 예측상 잘 접히고, 입력 문장과 기능적으로 맞으며, 서열 다양성도 갖췄다고 계산 평가에서 보여 줍니다. 다만 이 점수들은 “실험할 후보를 고르는 우선순위”의 근거로 제시된 것이지, 그 자체가 기능의 증명은 아닙니다.
한계와 과장 점검: “말만 하면 효소가 나온다”는 아니다
첫째, 네 과제 모두 성공했다는 말은 “각 과제에서 기능하는 후보를 최소 하나 이상 찾았다”는 뜻에 가깝습니다. 생성한 후보 가운데 몇 퍼센트가 기능했는지, 천연 효소 대비 활성이 어느 수준인지는 과제마다 다르고, 원문 전체를 확인하지 않은 상태에서 일반화하면 안 됩니다. 이번 글은 공개 초록과 논문 페이지 기준으로 썼습니다.
둘째, 1.7배라는 개선은 특정 CO2 고정 경로라는 맥락 안의 결과입니다. 다른 숙주, 다른 공정 조건에서도 재현될지는 별도의 실험이 필요합니다.
셋째, 학습 데이터의 “설명”은 기존 데이터베이스 주석에서 합성한 것입니다. 데이터베이스에 잘 기록된 기능(형광, 가수분해, 산화환원)은 문장으로 표현하기 쉽지만, 식품 현장에서 중요한 “쓴맛을 덜 내는 펩타이드를 만드는 단백질 분해효소”, “pH 4의 과즙에서도 버티는 효소” 같은 조건은 주석이 빈약해 모델이 제대로 이해할지 미지수입니다.
넷째, 일부 해설 기사는 성공률과 출시 날짜를 서로 다르게 전하고 있습니다. 숫자는 반드시 Nature 원문과 보충자료에서 다시 확인해야 합니다. AI가 제안한 서열은 여전히 예측이며, 발현·정제·활성·안정성 측정이라는 wet-lab 과정을 건너뛸 수 없습니다.
식품공학자 김종은 교수의 시각
저는 천연물과 기능성식품, 항노화 소재를 연구하면서 효소를 “도구”로 자주 씁니다. 배당체를 아글리콘으로 바꾸는 β-글루코시데이스, 단백질을 생리활성 펩타이드로 자르는 프로테에이스가 대표적입니다. 그동안 좋은 효소를 얻는 길은 대개 미생물을 스크리닝하거나 상업 효소를 고르는 것이었고, 원하는 조건에 꼭 맞는 효소는 드물었습니다.
Pinal이 흥미로운 이유는 설계의 입구가 “구조생물학 언어”에서 “연구 목표 문장”으로 내려왔다는 점입니다. 식품공학 연구실처럼 단백질 설계 전문 인력이 없는 곳에서도 후보를 받아 볼 수 있는 문이 열린 셈입니다. 하지만 저는 이 기술을 “효소 개발의 자동화”가 아니라 “실험할 후보 목록을 넓혀 주는 도구”로 봅니다. 식품 소재는 결국 안전성, 규제, 생산 비용까지 넘어야 하고, 설계 효소로 만든 소재가 식품에 쓰이려면 효소 자체의 안전성 자료도 따로 쌓아야 합니다. 문장 하나로 후보는 나오지만, 그 후보를 소재로 만드는 일은 여전히 실험실의 몫입니다.
우리 연구실이라면 무엇을 해 볼까
저희라면 거창한 신규 효소보다 비교 가능한 작은 실험부터 하겠습니다. 예를 들어 인삼 사포닌이나 플라보노이드 배당체를 전환하는 β-글루코시데이스를 목표로, “산성 조건에서 안정하고 특정 당 결합을 가수분해하는 효소”처럼 조건을 바꾼 문장 서너 개로 후보를 생성합니다. 각 문장에서 상위 10~20개를 골라 대장균에서 발현하고, 기존 상업 효소를 대조군으로 두어 전환율(HPLC), pH·온도 안정성, 반응 후 항산화·항염 활성 변화를 같은 조건에서 측정합니다.
이렇게 하면 “문장을 얼마나 구체적으로 쓰면 성공 후보가 늘어나는가”라는, 논문이 직접 답하지 않은 질문에 우리 데이터로 답할 수 있습니다. 실패한 후보의 기록도 남겨 두면 식품 효소 설계용 프롬프트 가이드로 쌓을 수 있다고 생각합니다.
이번 주 함께 볼 소식
- ImmuneAgent — AI 에이전트가 제안한 항체 후보 110개 중 60개가 중화능을 보였고 12개는 광범위 중화항체로 확인됐다고 보고했습니다. 후보 생성과 실험 검증을 연결한 사례입니다. arXiv:2610.03160
- CellNet — 40종, 2억 3,100만 개 세포 데이터로 만든 단일세포 기초 모델로, 종을 넘나드는 세포 표현 학습을 시도합니다. arXiv:2610.21943
- Autonomous Science Bench — 3개 분야 6개 캠페인, 144회 시도로 자율 실험 에이전트를 비교하는 벤치마크입니다. “AI가 실험을 잘 설계하는가”를 수치로 따지기 시작했다는 점에서 의미가 있습니다. arXiv:2610.18449
- NALCN 약물 재창출 파이프라인 — 승인 약물 약 1,200개를 대상으로 이온 채널 조절 후보를 찾는 계산·실험 연계 연구입니다. bioRxiv
댓글 0
첫 한 줄을 남겨 보자.
로그인 뒤 한 줄을 남길 수 있다.